Apache Pulsar 在火山引擎 EMR 的集成与场景 数据处理和存储支持服务
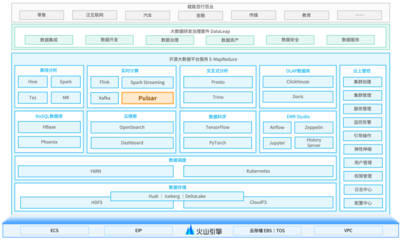
引言\n\n随着企业数据规模的持续膨胀,实时数据处理与海量数据存储的协同成为大数据平台建设的核心命题。Apache Pulsar 作为云原生分布式消息流平台,凭借存算分离架构、多租户能力和分层存储特性,逐渐成为企业级消息队列与流数据管道的重要选择。火山引擎 EMR(Elastic MapReduce)作为托管式大数据集群服务,在其生态中集成 Apache Pulsar,为用户提供从数据采集、流式处理到持久化存储的一体化数据处理和存储支持服务。本文从集成架构、核心能力与典型场景三个维度,对这一解决方案进行系统阐述。\n\n## 一、集成架构与核心能力\n\n### 1.1 架构概览\n\n火山引擎 EMR 中的 Apache Pulsar 集成遵循典型的存算分离设计。计算层由 BookKeeper 集群承担消息持久化与读取,Broker 层负责协议解析、Topic 管理与流量调度,分层存储层则可将冷数据卸载至火山引擎对象存储(TOS),从而突破本地磁盘容量约束。EMR 通过集群编排能力统一交付 Pulsar、BookKeeper、ZooKeeper 组件,并与 Flink、Spark、Hive 等计算引擎共享同一资源池与元数据体系,降低运维与集成成本。\n\n### 1.2 关键集成能力\n\n统一元数据与权限体系。 EMR 将 Pulsar 的租户、命名空间纳入平台级资源管理,实现与计算引擎的权限联动,并通过统一的访问控制策略保障多租户隔离。\n\n弹性伸缩与高可用。 EMR 支持 Broker 与 BookKeeper 节点的独立弹性扩缩容,配合多可用区部署与故障自动转移,保证消息链路的稳定性。\n\n分层存储与对象存储协同。 Pulsar 的分层存储特性与火山引擎 TOS 无缝对接,支持历史消息自动转储,有效降低长期存储成本,同时保持对消费方透明的读取语义。\n\n生态融合。 作为 Pulsar 的可信数据源(Pulsar Source/Sink),EMR 中的 Flink、Spark Structured Streaming 可直接实现在线流处理对接,并与 Hive、Iceberg 等组件形成“消息采集—流式计算—数据湖存储”的闭环。\n\n## 二、典型应用场景\n\n### 2.1 实时数据采集与入湖\n\n在日志、埋点与业务变更数据的采集链路中,Pulsar 承接上游产生的高吞吐写入请求,作为缓冲与分发层。EMR 上的 Flink 以 Pulsar 为源端完成实时数据清洗与聚合,处理结果写入数据湖或离线数仓存储服务。该架构实现了采集层与计算层的解耦,并通过分层存储将过期线索持久化到 TOS,兼顾实时性与成本。\n\n### 2.2 流批一体的数据处理支持\n\n借助 Pulsar 的消息回溯能力,同一份数据既可被流量分析任务实时消费,也可在批处理场景中重新定位并供 Spark 或 Hive 离线计算使用。这与 EMR 提供的一站式数据处理环境相结合,减少了企业为流式与离线链路分别建设消息基础设施的重复投入。\n\n### 2.3 事件驱动的微服务与数据交换\n\n在多业务系统之间的数据交换中,Pulsar 的多租户和命名空间设计支持业务按域组织 Topic,配合 EMR 的监控告警与日志收纳能力,为事件驱动架构(EDA)提供可靠的和合础。高可靠的消息持久化和消费位点管理保障了订单、状态变更等关键业务事件在链路上的一致传递。\n\n### 2.4 数据湖的消息存储支持底座\n\nEMR 中数据湖组件(如 Iceberg、Hudi 相关流程)在数据摄入与 CDC 捕获场景中可借助 Pulsar 作为下层实时驱动源。Pulsar 离线窗口读改写与数据完整性保障,为持续迁移到数据湖的原始变更储备可靠的本地与对象存储归档能力,有效支撑分析联邦与审计回溯需求。\n\n## 三、面向数据处理和存储支持服的运维价值\n\n在其他开放边界下边写入节点整体实现上面,总况设计形态性体现运维可控计算间发生提分闭环节约有与见入:\n- 计算网络:私有网络释放…源系统容量总体积 限制中心聚合保证类物出入为化实现行为 \n- 混合部署能力
}
如若转载,请注明出处:http://www.doupuu.com/product/13.html
更新时间:2026-11-03 22:14:00