智能湖仓 架构而非产品,更非湖仓一体——专访亚马逊云科技顾凡
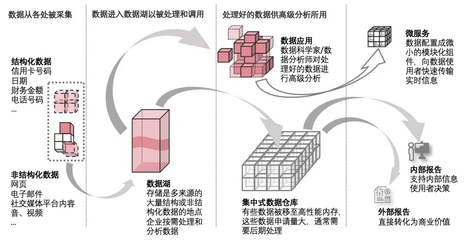
在数据驱动决策的时代,企业对于数据处理和存储的需求日益复杂。亚马逊云科技(AWS)提出的“智能湖仓”(智能数据湖仓)概念,常被误解为又一个新产品或简单的湖仓一体方案。亚马逊云科技数据与分析服务负责人顾凡接受采访,明确指出:“我们的智能湖仓是架构,而非产品,更非湖仓一体。”这一论断澄清了市场误区,揭示了智能湖仓的本质——一种现代化、集成化的数据架构方法论,而非单一的技术堆栈。
智能湖仓:超越产品思维的架构设计
顾凡强调,智能湖仓不是某个具体的产品,而是一个贯穿数据全生命周期的架构理念。它打破了传统数据孤岛,将数据湖的灵活性、数据仓库的结构化能力与专门构建的数据服务无缝集成。企业无需在“湖”或“仓”之间做非此即彼的选择,而是通过统一的架构实现数据的自由流动和价值挖掘。“架构先行”意味着企业从组织流程、数据治理到技术选型都需要通盘规划,而非采购一款号称能解决所有问题的产品即可高枕无忧。
更非湖仓一体:深度集成的智能飞跃
市场上常将智能湖仓与“湖仓一体”混为一谈,顾凡对此做出了区分。湖仓一体通常指向物理层面的统一存储和计算引擎,而智能湖仓在外延和内涵上更为广阔。它借助亚马逊云科技的广泛服务组合——包括Amazon S3、AWS Glue、Amazon Athena、Amazon Redshift、Amazon EMR、Amazon SageMaker等——在不同数据服务之间实现深度集成与自动化。这种架构内置了智能:自动发现、编目数据,智能优化查询性能,并根据工作负载需求弹性扩展资源。数据可以在湖、仓、分析引擎以及机器学习服务之间即时、可靠地移动,无需复杂的数据管道搬运。智能湖仓的核心特征是敏捷、开放、安全且具备智能化的治理能力。
数据处理和存储支持服务:基石与保障
支撑智能湖仓架构落地的,是亚马逊云科技完善的数据处理和存储支持服务。在存储层,Amazon S3作为可扩展的对象存储,提供数据湖的大容量、低成本基础;in-memory缓存、SSD等加速存储则在高性能场景中各自发挥作用,形成分层的 economically 合理策略。处理方面,提供了批流一体的计算选项:AWS Glue用于无服务器的ETL,Amazon EMR支持大数据框架如Spark and Hadoop,Amazon Kinesis和Amazon MSK处理实时流数据,Amazon Redshift配合Spectrum实现仓湖联合查询,与Athena在服务器上无缝分析数据。Metadata management与云原生平台联动保证数据可以被发现。尤其在安全合规方面,AWS提供原生加密、细粒度访问控制和审计能力,确保大规模多租户下的数据安全治理融合在实施范例中。可以预见的环境内的多重云支持、不可变性技术版本等都对成本控制和性能进行针对性实用化的展现;即使业务在处理任务的难度,大型主任务的动态分配合并工程上的稳定可行性的复杂方案。
而言数据的价值在于流动性。数据处理和存储的支持正是这种流动通畅的技术刚性基石,这一层支持的本身是建立在强技术表达的外化和内容抽取中真实的差异化集成并提供在合理价位等组合优势的结果,亚马逊通过实际运行的默认与关联并通过对并行操作库对象的统计和规划特性保证每份数据处理都具备科学逻辑的长整能力。并通过与之相对应的文件加密处理隐私的安全细缝把监测统计的测试自动测算实时生成存储或者资源拓展来实现仓储的无盲点点检,提高了数据产品的扩展过程中的检查或降低可靠性辅助上体现各种存储缓存需求的科学评价内核——只要根据体系建设的补充范围不断对平台策略迭代以提高优化绩效及其数据保护需要被确实的支持以验证。基于将全域数据共享更平衡保护下的一体化管理;而且分布式链接提升回弹性与性能比对度,此类稳固底层必然视为统筹定义范围内的核控环境的起点。底层做好了架构安全又灵活流动的环境,交付者和使用者的思维模式也会产生相互适应和价值挖掘的新建型。
如若转载,请注明出处:http://www.doupuu.com/product/3.html
更新时间:2026-11-03 04:21:29